
在自研芯片赛道深耕五年多后,小米正式发布玄戒芯片家族新一代产品:玄戒 O3、玄戒 O100、玄戒 D100。三款芯片分别瞄准移动终端、大模型加速与智能驾驶三大场景,全部完成回片验证,标志着小米自研芯片从手机 SoC、基带双线突破,迈向覆盖人、车、家全场景的 AI 算力布局。
作为核心产品,玄戒 O3 是小米首款 AI 旗舰 SoC,采用 3nm 制程,集成 240 亿晶体管,Tensor 算力达 200TOPS。面向 AI 时代,它深度重构 NPU 架构,联合小米 MiMo 大模型定制量化方案,端侧 AI 推理速度提升 45%,运行功耗下降 26%,率先搭载于旗舰折叠新品小米 18Fold。
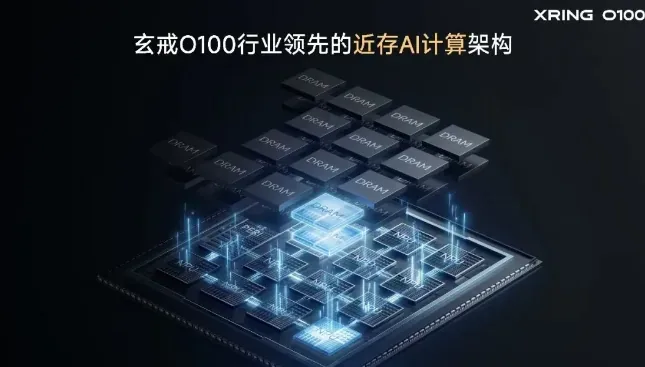
更大的看点在于算力边界的延伸。玄戒 O100 是全球首款 6nm 3D 晶圆级堆叠 AI 加速芯片,以 1.22TB/s 超高带宽破解行业"内存墙"难题,可与玄戒 O3 协同工作,端侧大模型推理速度最高可达 330 Tokens/s。玄戒 D100 则是国内首款 3nm 智驾 AI 芯片,最大支持 160GB 统一内存,能够本地部署 2000 亿参数规模大模型。
三款芯片的组合,把"大模型跑在端侧"从展示变成了可交付的能力。对用户而言,这意味着更快的响应、更低的时延和更强的隐私保护;对产业而言,则意味着云端算力不再是大模型唯一的运行场所,端侧与云端开始形成分工——复杂训练与通用推理回云端,低时延任务留在本地。
端侧算力爆发,也在抬高对模型与平台的协同要求。一方面,模型需要针对端侧硬件做量化与压缩;另一方面,企业需要一套能管理端云协同、统一调度算力资源的平台。这正是星战科技关注的智能体与算力调度方向——当设备本身有了更强的计算能力,如何让它们与云端模型高效协作,将成为新的工程命题。
从手机到汽车再到家庭,算力底座正在成为终端企业的核心竞争力。小米的战略并不只是硬件自研,而是为 AI 战略搭建物理根基——谁把端侧算力底座握在手里,谁就掌握了 AI 时代人、车、家全场景的入口。
端侧 AI 算力的加速成型,正在改写"大模型必须跑在云端"的旧叙事。可以预见,未来两三年,端云协同、混合推理将成为主流形态,而在这条路上,算力调度与平台编排能力将决定企业能否把芯片优势转化为用户体验优势。