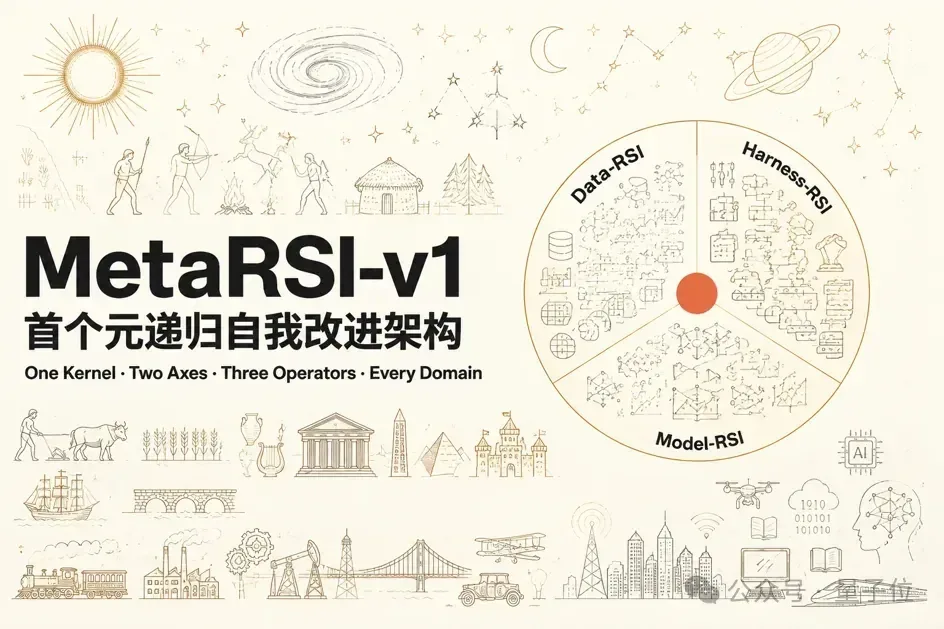
让模型自己生成训练数据、自己改写提示词、自己修复代码,这条路线被称为递归自我改进(Recursive Self-Improvement,RSI)。但几乎所有RSI系统都是同一套结构:一个固定不变的改进程序,反复作用于模型,且往往只从Harness、Data或Model RSI的单一视角切入。
为回应这一难题,CosmosMind联合斯坦福、伯克利、MIT、清华、北大等十余家海内外高校发布MetaRSI-v1,称其为全球首个统一Model-RSI、Data-RSI、Harness-RSI的元递归架构,能够改进“自我改进的过程”。在没有外部教师模型参与的情况下,它让一个仅30亿激活参数的小模型在四项基准上平均自我提升10.9分,并让GPT-5.6、Claude Opus 5等六款前沿旗舰模型平均提升7.3分。
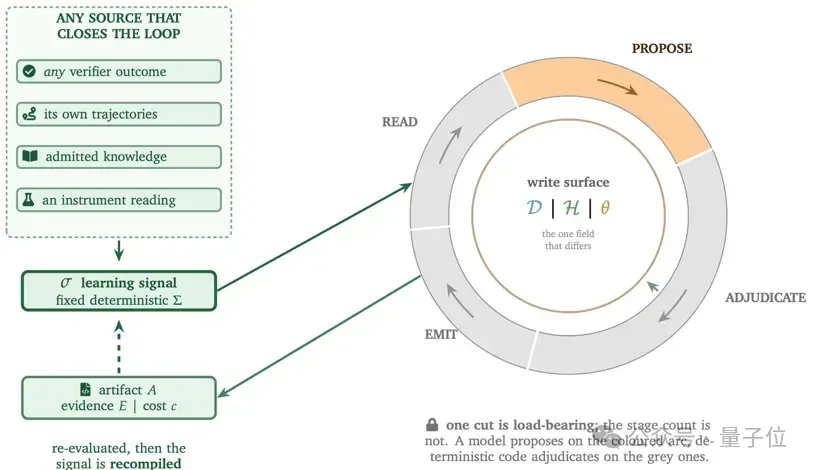
MetaRSI-v1提出了Loop Kernel范式,把“进步如何发生”抽象成一条与对象无关的闭环:消费反馈得到学习信号,在Data、Harness、Model上提出改动,交由验证器裁决,再将结果回流为下一轮信号。Data、Harness、Model由此成为同一Kernel的不同实例化算子,可组合、可统一调度。
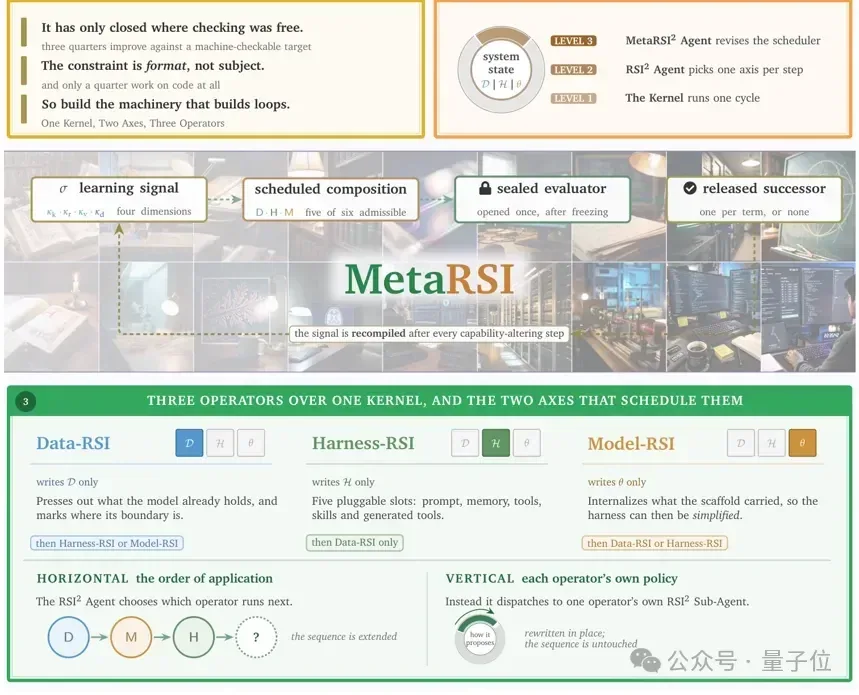
沿着同一内核,改进在三个空间展开:Data-RSI从自身运行轨迹提取学习信号,用于合成数据;Harness-RSI在System Prompt、Skill、MCP、Tools、Memory等可插拔槽位上做加减法;Model-RSI则更新模型自身的参数与结构,把反复验证有效的行为内化。整套架构由四个Agent协调运作,并可被人类专家局部替换,形成human-in-the-loop系统。
这与星战科技在智能体协作与算力调度上关注的方向相通:当系统自己去试错、评测和迭代,算力消耗与验证质量就成为能否持续的前置条件。RSI会大量重复生成与执行,如果没有统一的资源调度与过程治理,改进很容易停在实验阶段。MCP工具槽位、Skill与Memory的编排,也正对应协作平台需要长期沉淀的能力。
值得注意的是,RSI的统一并不意味着风险消失。当改进过程本身也被优化,评价标准是否可靠、哪些改动真正有效,都需要被独立验证。越是能自我加速的系统,越需要可观测、可回滚、可审计的工程约束,否则“进步”可能只是评价器被绕过的假象。
RSI进入“平方时代”,标志自我改进从单点技巧走向体系化架构。但能力越强,对验证与资源的要求越高。谁能把改进过程管住、把算力用稳,谁才可能把递归自我改进真正跑成长期能力。