
无问芯穹联合清华大学、上海交通大学开源具身智能端侧推理引擎APXInf,目标不是让模型在机器人上能跑,而是在有限的算力、功耗与成本约束下,跑得够快、够稳,也足够容易接入。
它公布的核心数字很直接:PI 0.5 FP8在Jetson Thor上的端到端推理延迟从278毫秒降至26毫秒以内,推理频率达到38.46赫兹,满足机器人多场景实时控制对推理频率与响应延迟的要求。
端侧推理的难点并不只是峰值性能。机器人要连续感知、决策与执行,几百毫秒的差异在聊天场景只是体验问题,在机器人身上则可能是动作迟滞、轨迹不连贯,甚至多次任务失败。
同时还有一笔现实的经济账:算力成本、功耗与有限硬件资源的利用率。简单把云端推理框架搬到机器人本体,往往很难兼顾小批量、低延迟与持续稳定运行。
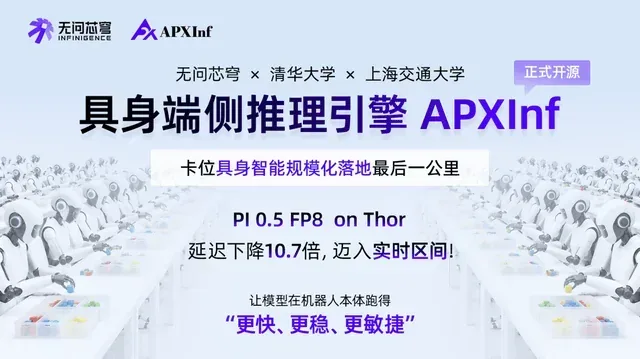
APXInf用Rust构建极简运行时、以Python保留易用接口,并围绕机器人真实执行链路做端到端优化,支持Jetson Orin、Jetson Thor与RTX 4090等平台,还规划了国产芯片算力后端与国产操作系统的适配。
这类工作揭示的方向是,具身智能的规模化依赖训练与推理两端接续:模型训练完成后,还要有稳定的部署与调度能力承接。星战科技在GPU算力平台与算力调度上的投入,正是为了让这种从云端到本体的链路更顺畅。
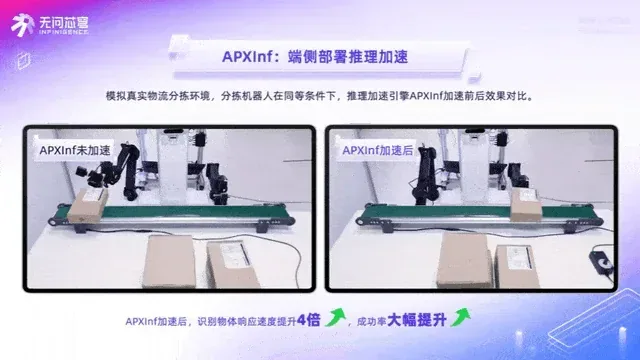
当端侧延迟被压到毫秒级,机器人得以进入更实时的工作状态,但要在不同模型、不同硬件上稳定复现,还需要标准化的接入方式与持续迭代的工程体系。
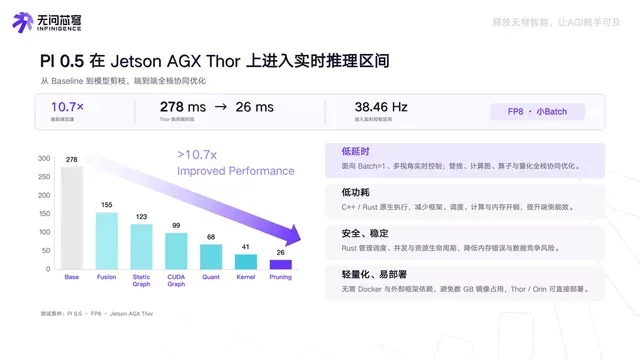
从演示到产线,具身智能缺的往往不是又一个更强的模型,而是把模型、硬件与场景串起来的推理基础设施。谁先把最后一公里补齐,谁就更接近规模化落地。