
AI for Science的竞争正在向科研闭环延伸。以蛋白设计为例,模型越来越强,但研究人员仍然要找文献、查结构、配环境、提交计算,再换工具筛选候选,各个环节长期靠人手动接续。
杭州AI蛋白设计公司力文所发布Lévin Harness,面向科研社区开放使用,把数据、模型、插件工具、算力与工作流放进同一个Agent工作区。
在工作台里,通用大模型负责理解需求、规划步骤,专门训练的科学模型承担结构预测与序列设计等计算,Harness则负责连接能力、数据和算力,并保留研究过程。
以binder设计为例,Agent可以参与靶点调研、整理信息、辅助分析结合位置,研究人员再确定方法与约束。内置的三维分子可视化让屏幕上的结构信息直接进入Agent上下文,使讨论指向一个明确的研究对象。
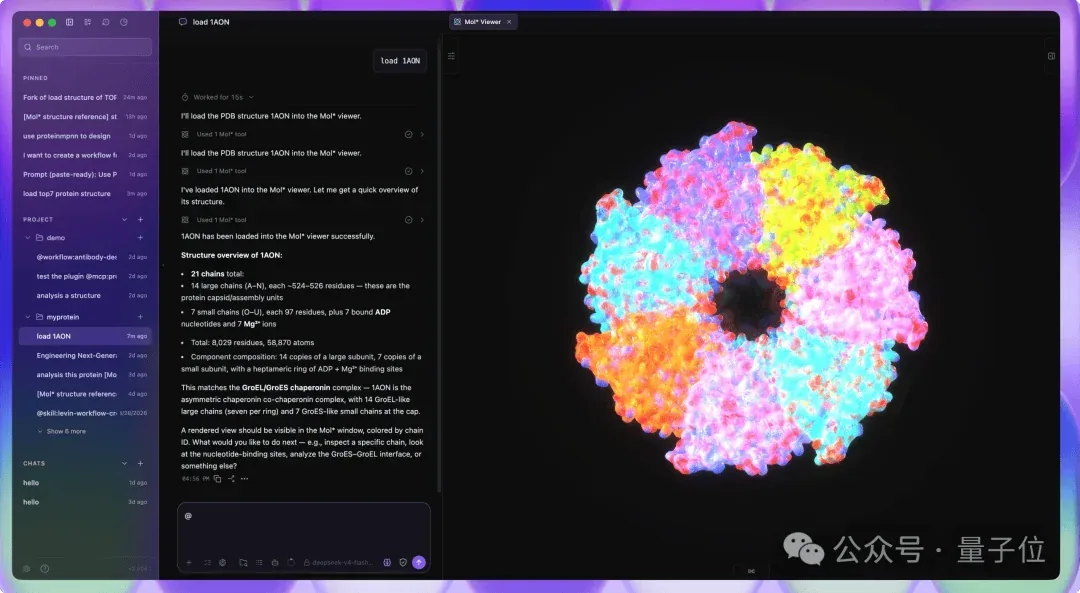
工具变多本身也会产生工作量:不同模型的输入输出与运行环境不一致,上一项计算的文件如何交给下一项,设计条件如何转换成参数,都需要有人处理。Harness用插件系统把这些能力接进同一环境,并支持连接本地工作站或远程GPU服务器。
这正说明,AI for Science的瓶颈往往不在单个模型,而在模型之外的流程衔接:模型选择、工具组合、算力接入与结果反馈能否接续起来。星战科技在GPU算力平台与算力调度方向的投入,正是为了让科研与产业任务中的异构计算更易组织。
对研究机构而言,数据边界同样关键。未公开的靶点、候选序列与实验结果,要求工具明确项目数据保存在何处、由谁决定备份,外部智能才能真正进入核心研发环节。
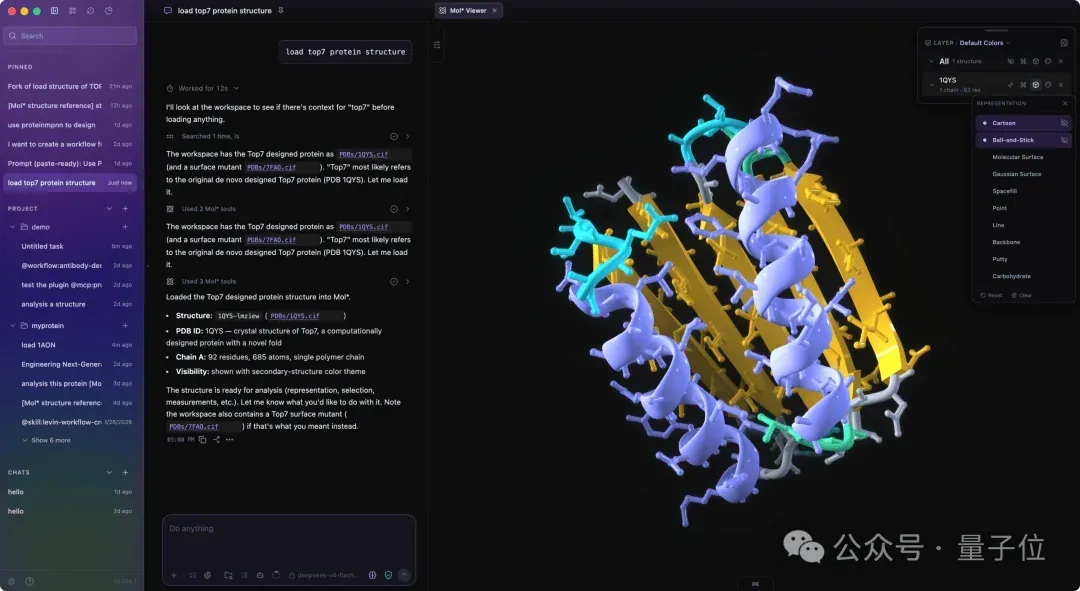
当可执行、可复用的研究方法沉淀为工作流,科研经验才得以延续。AI for Science的下一步,或许就是让这些闭环持续运转下去。