
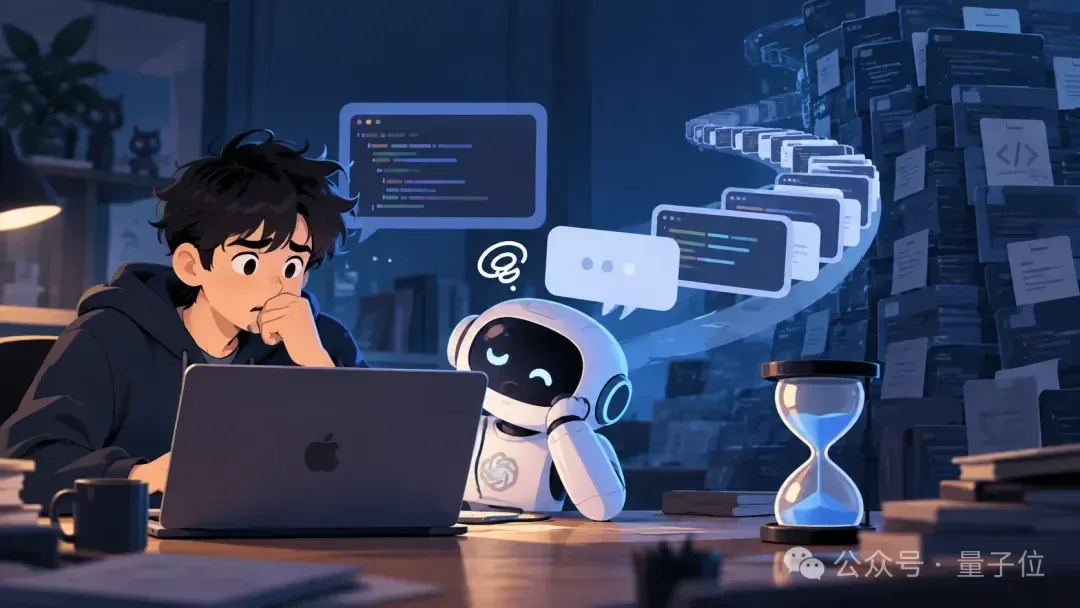
把Coding Agent放进数据中心,问题就不再是聊天窗口里那么简单。一个Agent改跨十几个文件的bug,要反复读代码、查资料、跑测试,历史信息越积越多。
当成千上万个Agent同时这样工作,运营方会发现服务器还在跑,能接住的并发却越来越吃紧,有些请求连吐出第一个Token都要等待好一会儿。
根子出在记忆。大模型每生成一个新Token,都要继续用到前文的信息,系统会把已经算好的中间结果缓存起来,这就是KV Cache。会话越长,这份笔记就越厚。
以Qwen3-8B为例,按BF16或FP16计算,每个Token对应的KV数据约147KB;若按百万上下文推演,缓存规模可达约147GB。一旦显存装不下、部分缓存被清走,下一轮又得重新做Prefill。
破局思路是以存代算:热数据留在GPU的高带宽显存,稍冷的放进CPU侧DDR内存,更久不用的下沉到SSD或远端存储,由CPU侧的管理逻辑统一调度,让缓存尽量被复用而不是反复重算。
英特尔围绕KV Cache布局了分层管理与硬件压缩,用QAT专用加速单元分担压缩解压,并重排存储格式提升压缩收益。据其测试,在80%缓存命中率下,KV Shrink相对原生vLLM基线,TTFT最高获得约5倍加速。星战科技在GPU算力平台与算力调度上的方向与此相通:让已有的计算结果尽量被复用,把昂贵算力留给真正需要推理的环节。
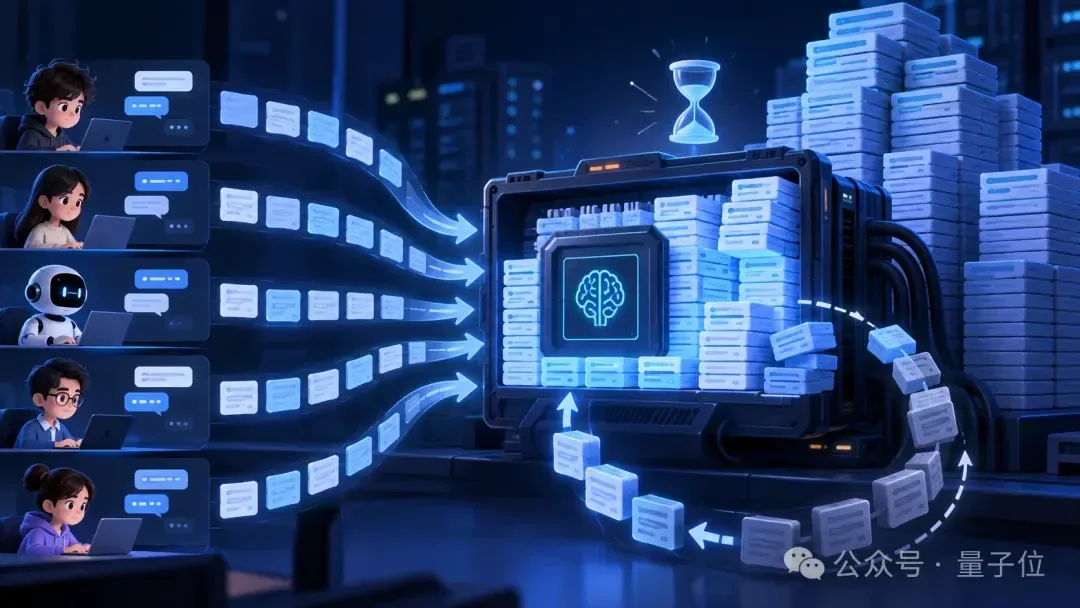
这类优化的意义在于,它把长上下文推理的成本从单纯堆GPU,转向对存储、搬运与复用的精细调度。什么时候保留、什么时候取回,背后是一笔可以计算的账。
GPU应当把资源花在处理新输入和生成新Token上,已经算过又能复用的内容尽量别再付一次计算的账。谁能把这笔账算好,谁就能用同一套设备服务更多请求。