
11 月 4 日,腾讯混元发布新一代大语言模型 Hy4,首次引入视觉能力,同步在腾讯多款产品上线。API 定价与上一版持平:每百万 tokens,命中缓存输入 0.3 元,输入 6 元,输出 18 元。配合上线,11 月 4 日到 15 日部分产品提供免费额度;即日起至年底,腾讯云 TokenHub 按刊例价五折计费。
11 月 2 日晚,阿里做了另一件事:把千问办公会员月卡放进一场头部带货直播,原价 28 元,0.01 元上架,半小时售出约 10 万份,对应约 2 万亿 Token。
两件事放在一起看,Token 的身份变了。它原本是大模型的计量单位,现在成了可以下单、可以打折、可以清仓的商品。
但企业这边的体感不是这样。
钛媒体最近一篇文章里提到一个现象:豆包月活超过 2 亿,日收入不足百万元。投资者关注的东西也在挪位置——从模型的参数和榜单,移向任务的完成量和消耗的量。文章把这句话说得更直接:AI 的价值单位,正在从「能力」变成「用量」。
用量一旦成为计价基础,问题就从「用哪个模型」变成「这笔钱怎么算」。
先看单价。同样是百万 tokens,不同模型的价差不是一点半点。DeepSeek V4-Pro 输入 3 元、输出 6 元;Qwen3.7 Max 输入 2.5 元、输出 10 元;Kimi K2.6 输入 6.5 元、输出 27 元;GLM-5.2 Ultra 输入 10.25 元、输出 32.23 元。输出价差五倍以上。
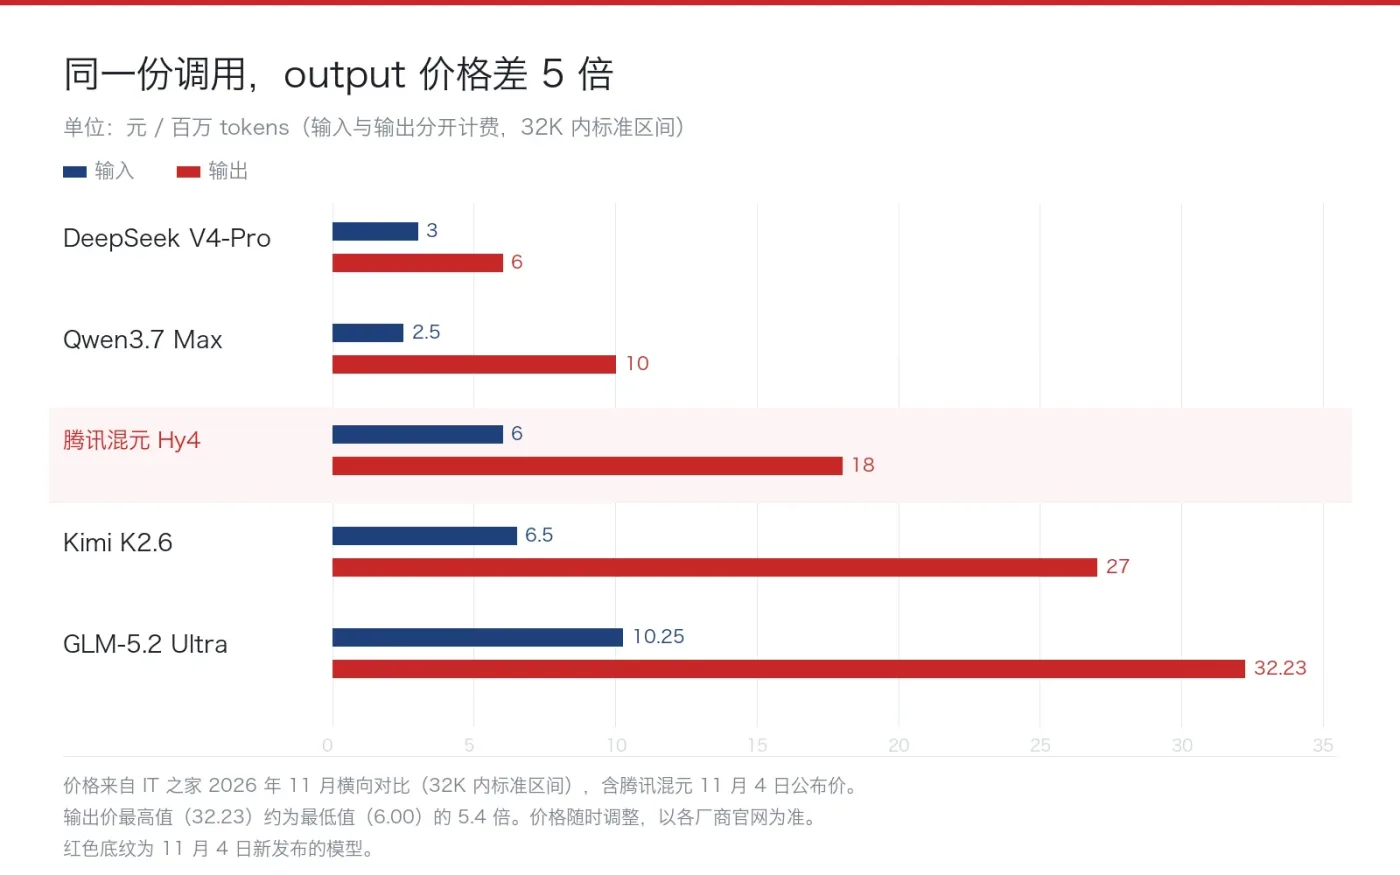
再看计费规则。输入和输出分开计费,缓存命中的部分打折,长上下文分段阶梯加价。一家企业同时用三个模型,就等于同时维护三套计费口径、三份账单、三种配额规则。
不少公司的实际状态是:技术团队按效果选模型,财务按总额看支出,中间没有人能把「这个月多花的八万块,是哪条业务线、哪个模型、哪类请求造成的」说清楚。
这跟管理能力无关,是结构问题。模型越多,口径越碎。
智连 OpenAPI 做的事很朴素:把 390+ 主流模型的调用收进一个入口。base_url 换成 openapi.xingzhan.cloud,其余代码不用改;换模型只改 model 参数。往上一层,它做三件企业用得上的事——
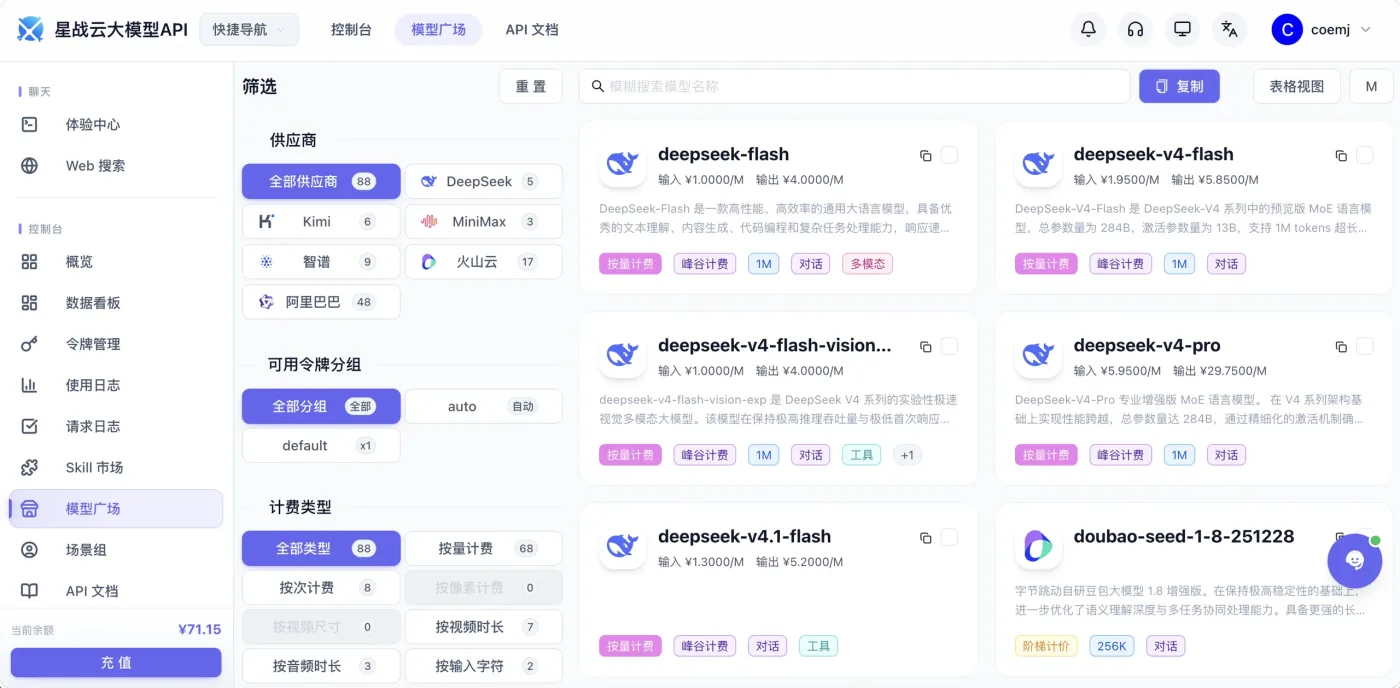
统一计费口径,不同模型的用量按同一套规则换算,配额快超时预警,账单可以导出。
智能路由,实时看各厂家的延迟和响应速度,按服务质量择优调用,某一个挂了自动切走。
权限分级,密钥管理、访问控制、项目隔离,谁的调用算在谁头上是清楚的。
一个网关解决不了模型选型的问题,但它能解决「账算不清」这件事。而后者,恰恰是现在企业用 AI 绕不开的一环。