
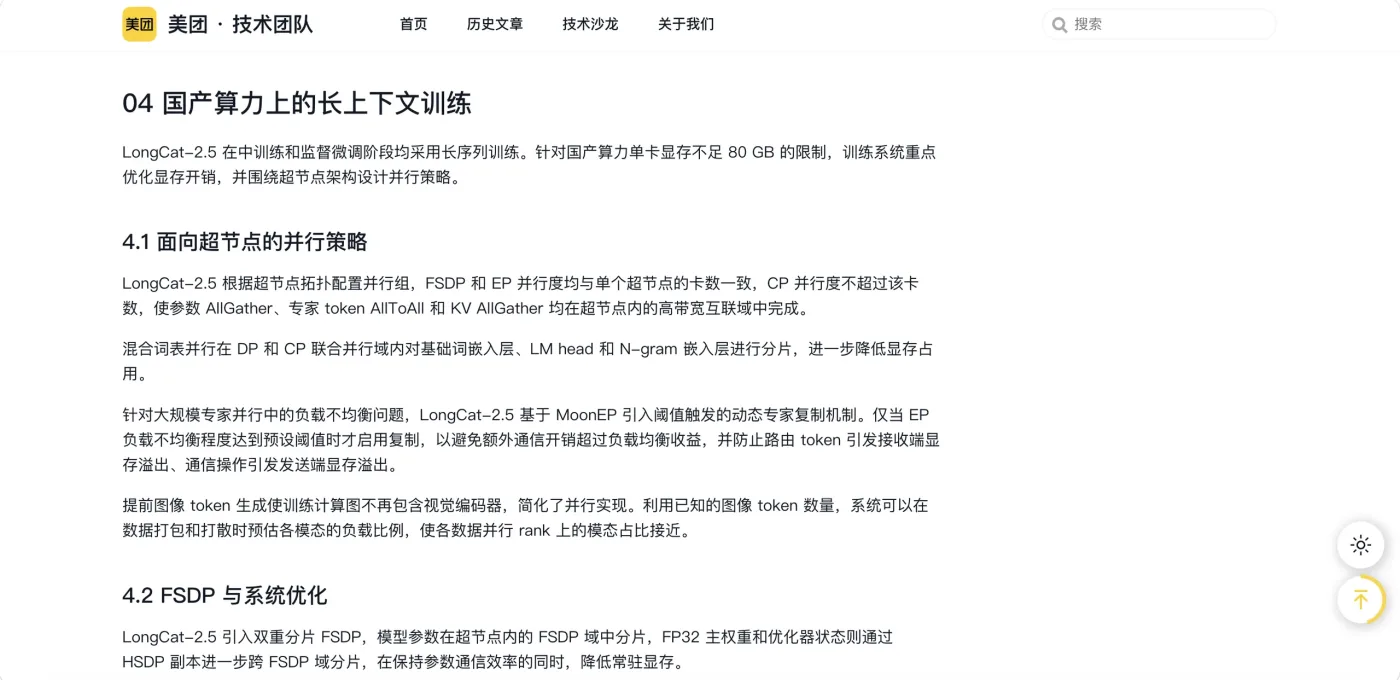
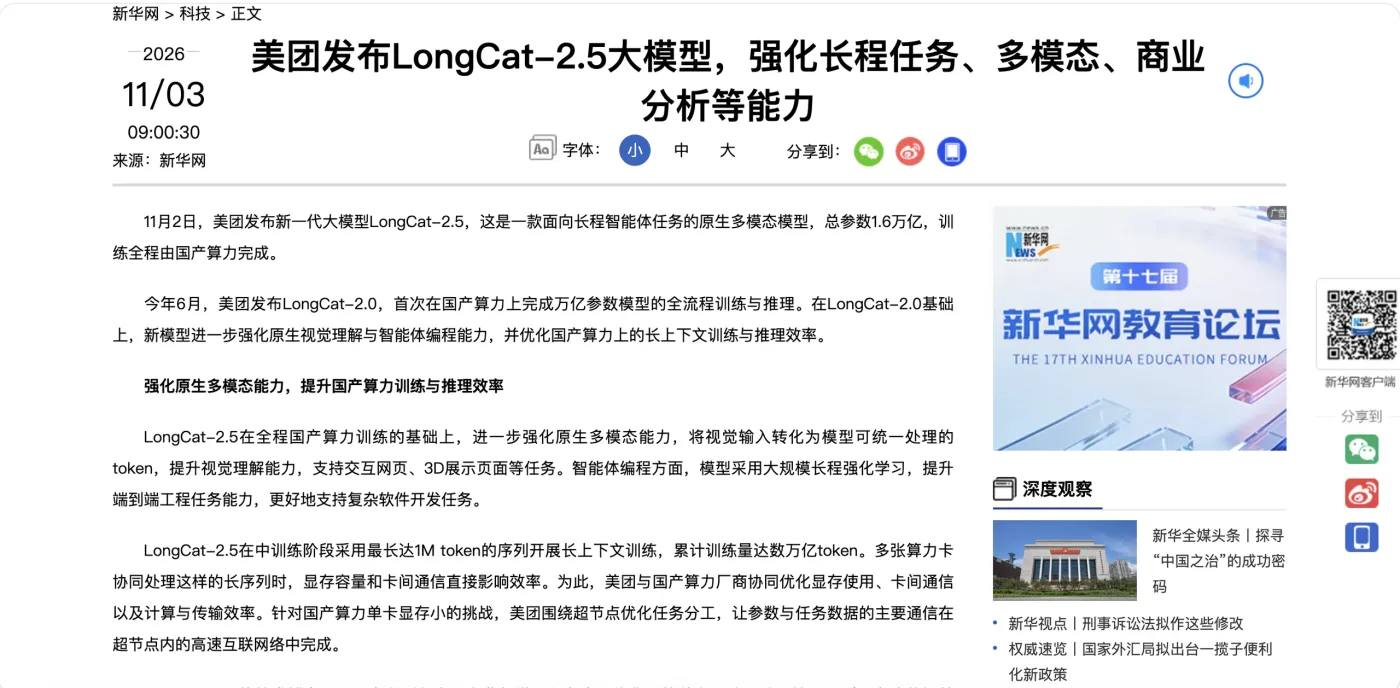
11 月 2 日,美团发布 LongCat-2.5,1.6 万亿参数,每个 token 激活约 480 亿,训练全程由国产算力完成。技术博客第 4 节写了一个前提:国产算力单卡显存不足 80GB。
一张卡装不下,就得多卡并行。卡一多,参数同步、专家路由的 token 分发、KV 缓存搬运都要在卡之间来回跑,通信时间吃掉本该用于计算的算力。不少团队算完这笔账,把国产卡用在推理上,训练留在英伟达。
美团的做法是把通信压在机柜里。并行策略按超节点拓扑配置,FSDP 和 EP 的并行度与超节点卡数对齐,参数聚合、专家 token 全交换、KV 聚合都在超节点内的高带宽互联域完成,尽量不出机柜。长上下文监督微调任务上,单卡吞吐比 DDP 基线提升 86%,一张卡干出约 1.86 张卡的活。
训练规模也压得住:中训练阶段最长 1M token 序列,累计数万亿 token。推理侧用 W4A4 把专家权重和激活同时量化到 4 比特,对比 W8A8 INT8 基线,输入和生成吞吐均提升约四成,首次输出等待缩短约 16%。
想用这套能力的企业,路分两种。自己训,长序列任务在国产卡上能跑出多少吞吐,超节点互联通不通、并行策略配不配得对,直接决定同样任务要几倍卡时。拿来用,LongCat-2.5 面向长程智能体,一次任务连续跑很多轮,压力落在推理并发和首字延迟上。
自己训这条路上,机房可以先不建。星战智算 GPUCloud 支持数据并行、模型并行与流水线并行,可一键提交多机多卡训练任务;长序列吞吐要压测,就开一组实例跑一轮。实例按需启停,按量计费,闲置不产生费用,压完就停。稳定跑量之后再谈包年,比一开始按峰值配一批卡划算。
今年 6 月 30 日,LongCat-2.0 在五万卡国产集群上完成万亿参数模型的全流程训练与推理;7 月 6 日以 MIT 协议开源,昇腾、摩尔线程、沐曦同日完成推理适配。到 2.5 是连续第二代。
卡够不够用,6 月那次已经答过。轮到自己这边,要测的是两个数:同一份长序列任务,在自己的卡型上多花几倍卡时;4 比特量化之后,下游任务的精度掉多少。差距在缩小,还没到闭眼换的程度。这两个数得按自己的模型和数据跑一遍,比读十篇评测有用。