静态互联网数据的增长红利正在见顶。元空智能团队给出一个判断:下一轮模型能力的跃迁,会越来越依赖与真实环境持续交互的“端侧”。这家从北大走出来的公司,三年前靠国内最早一批AI Excel产品ChatExcel出圈,如今已从云端应用延伸到本地端侧。
近期,元空一口气发布端侧模型Boxer、面向办公场景的元空AI Work,以及科研Agent元空AI Science,从模型、Agent到设备侧形成闭环。更直接的市场信号是,其端侧模型拿下惠普商务电脑预装,从高校实验室走出的团队由此进入全球头部硬件厂商的设备里。
团队把端侧AI重新定义为“生产力=元空端侧AI=模型×Agent×设备”。这意味着端侧不再是一条“把模型搬下来”的单向链路,而是一套能自己转起来的飞轮:设备产生真实交互数据,Agent在本地完成任务并产生反馈,模型据此持续更新。相比一味把更强的模型塞进设备,这条路线更强调长期运行中的进化。
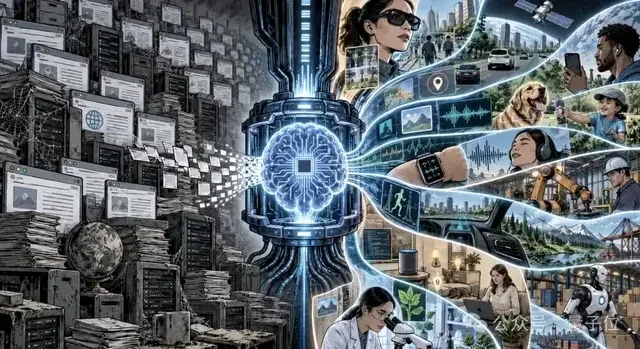
支撑这一判断的,是数据侧的压力。斯坦福《AI Index 2026》报告提出“Peak Data”,指向高质量人类生成数据正接近被前沿模型吃透;Hugging Face等团队的研究也在模拟模型反复使用已有数据后的效果衰减。当静态数据红利趋弱,真实任务、真实环境与持续交互产生的数据,价值随之上升。科研Agent把文献检索、数据分析一路接到真实实验设备,正是这条逻辑的延伸。
这与星战科技在AI实训平台与企业AI落地上关注的方向一致:端侧和本地化部署让数据不必全部上传,也让模型更贴近具体业务;但要让能力真正沉淀,仍需要有平台把模型、Agent、工具与算力组织起来,让人和团队能在真实任务中训练与验证。AI实训的价值,正在于把“会用AI”变成可复制的工程能力。
当然,端侧AI的约束同样明显。设备算力、功耗、隐私与模型更新都要在本地权衡,“会进化”也意味着版本管理、数据回流和安全边界更复杂。从“能跑”到“长期跑”,考验的不只是模型压缩,而是整套端云协同的工程体系。
当模型红利从静态数据转向真实交互,端侧就有了独立的价值。但能力能否被稳定交付,取决于平台化的组织能力与工程纪律。谁能让设备、Agent与模型形成可持续的飞轮,谁就更接近端侧AI的规模化落地。