
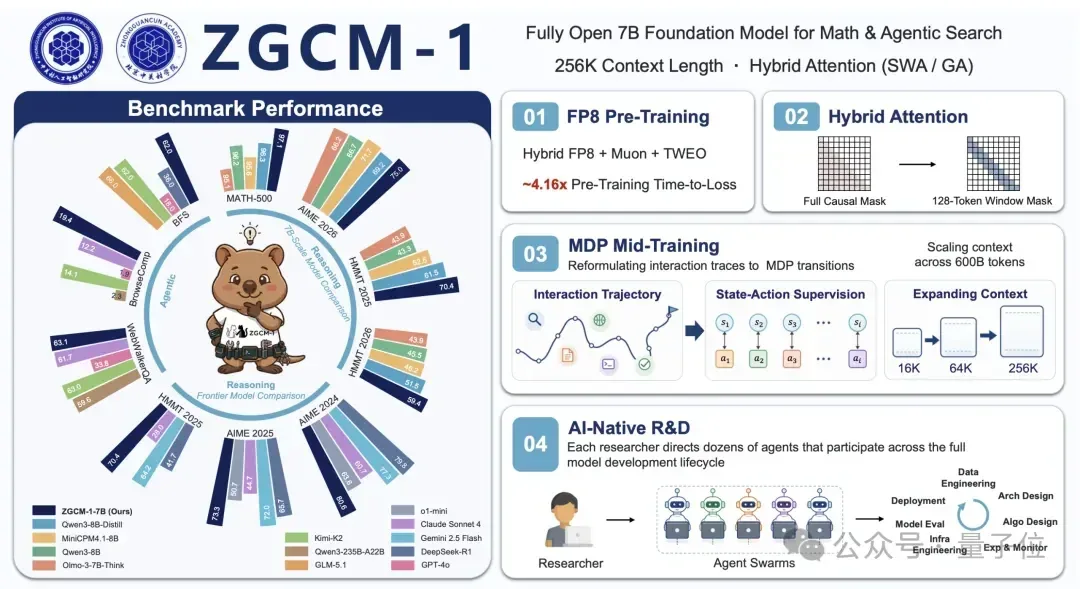
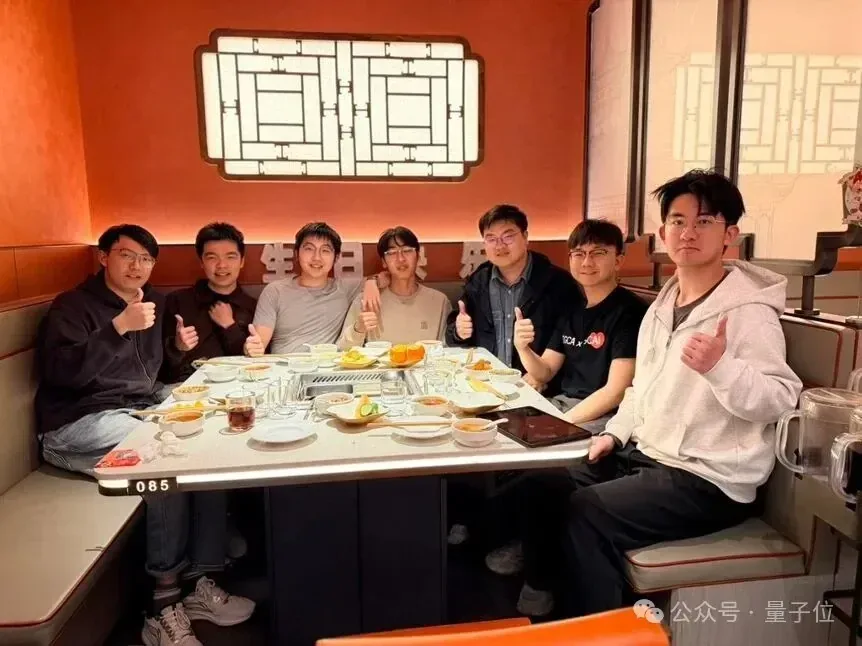
北京中关村学院7名博士生,用一个暑假从零训练出一个7B大模型ZGCM-1。随后,他们把各阶段训练数据与配方、模型权重、训练代码、中间checkpoint和日志一并开放,让研究者可以追溯、复现整个流程。在多项通用评测中,ZGCM-1与Qwen3-8B等同规模模型表现相近,在部分数学推理与搜索任务中还能与更大规模模型比较。
比分数更值得关注的是方法。数据、训练、集群、评测这一整套工程,在大厂通常需要几百人协作,七个人很难覆盖。于是他们给自己组建了一支几百个Agent的团队,分头处理数据、跑实验、看日志、做评测,实践「AI4AI」的研发范式。
分工并不简单。他们逐渐分出做数据、跑实验和做评测的Agent子团队,还搭建了类似论坛的任务发布与汇报系统,让任务有人接、进展有地方看、结果能被检查。自研平台把会议讨论与研发决策积累成共享上下文,再把验证过的脚本、工作流与debug经验沉淀为可复用的Skill,后来加入的Agent可以接着此前的经验做事。
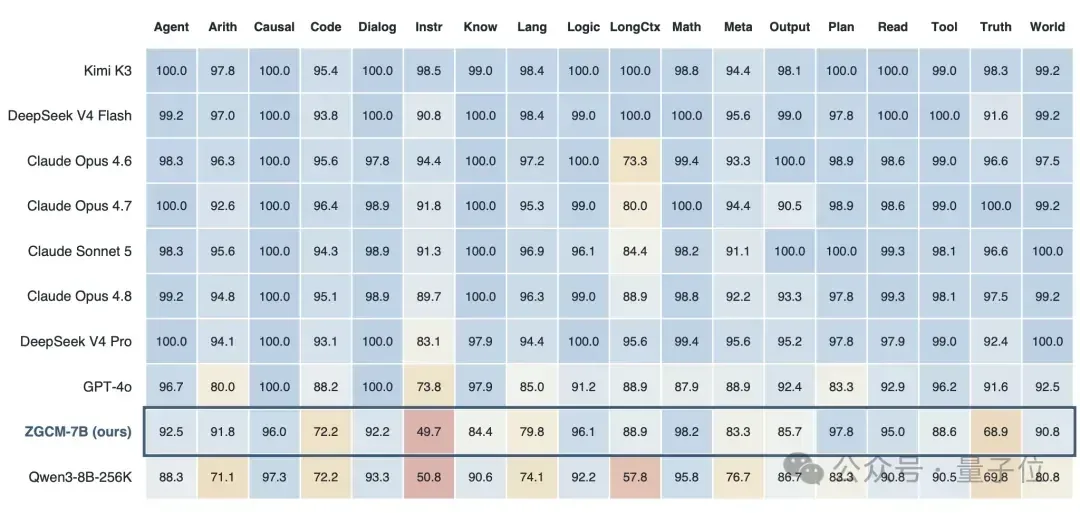
但Agent并没有让坑自动消失。一次训练中,loss仍在下降,模型能力却突然退步,最后追到数据分片与shuffle环节——实际送进训练的数据比例发生了波动。此后团队不敢只盯loss,改为更密集地保存checkpoint,并建立把能力拆成18类、183项、2503个探针的评测体系。他们还请核心参与者按L1到L5框架给Agent自主性评级:实验监控与部署到了L4,模型架构与学习算法设计仍在L2。
这与星战科技在AI实训平台与OPC智能体协作平台上关注的方向一致:把模型、Agent、工具与算力组织起来,让人和团队在真实任务中训练与验证。AI实训的价值,不只是教人「会用AI」,而是把人机协作的分工、约束与验收做成可复制的工程能力,让多个智能体能在明确边界内协同并沉淀经验。
效率同样是这套实践的一部分。团队采用局部注意力与全局注意力结合的架构,把上下文从16K逐步扩展到256K;在256K下,相较全注意力方案带来约3.94倍吞吐提升,KV Cache占用降至约六分之一。他们还结合Muon与FP8改善训练效率,并发现SFT阶段更严格的质量筛选让样本减少约44.9%,整体评测反而有所提升。
几个人带着几百个Agent,确实能把许多工作做起来,但距离让AI独立承担整个研发过程还有距离。真正有价值的不只是模型,而是被记录下来的过程。