
新一代同声传译大模型 Qwen3.8-LiveTranslate 正式发布,在翻译质量、延迟、说话人识别和语音合成四个维度上全面升级。该模型采用音频-文本交织的 Interleave 架构,把流式理解、文本输出与语音生成整合为单条因果序列,字均延迟从上一代的 2.8 秒压缩至 2.3 秒。
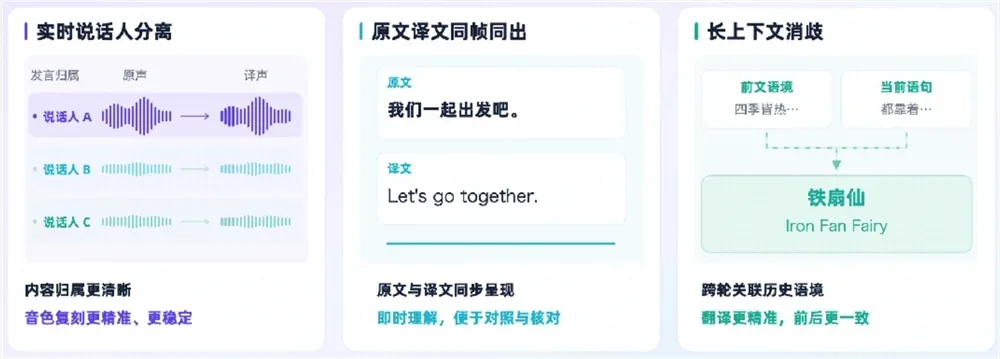
实时同传一直是检验大模型工程能力的场景。它比普通文本生成更苛刻,因为既要理解、又要翻译、还要合成语音,任何一环出现抖动都会被人耳直接感知。这次更新的三大看点,是实时说话人分离、原文译文同帧同出,以及长上下文消歧,指向的都是同一个目标:让翻译反应更接近自然对话。
模型采用 Hybrid MoE 的 Thinker–Talker 双模块设计,Thinker 负责理解与翻译,Talker 负责合成保留原音色的译文语音。在覆盖 14 个语向的多说话人长音频评测集上,官方称其在翻译忠实度、流畅度、简洁度及说话人分离错误率上均优于当前主流实时同传系统,目前支持 60 种语言,API 同步上线千问 AI 平台。
不过,实时能力的真正门槛并不在跑分,而在时延、并发、成本与稳定性的综合平衡。企业要接入的往往不止一个模型,不同任务的时延要求、计费方式和调用协议各不相同,接口碎片化会让切换成本迅速上升,很多能力因此停在演示阶段。
这正是星战大模型 API 广场关注的问题。通过统一的调用接口汇聚多家大模型,企业可以按场景选择模型并相对平滑地切换,让实时翻译这类能力更快进入客服、会议和跨境协作流程,而不是卡在逐个对接的工程细节里。
时延从 2.8 秒降到 2.3 秒,看似只是零点几秒的优化,背后却是交互节奏的改变——从“等待一段时间再看到结果”,走向更接近同步的体验。这类看似微小的工程进步,往往比一次参数提升更能改变产品形态。
团队表示,下一步将聚焦端到端时延的极限压缩、跨会话长期记忆以及更多语种覆盖。方向已经很清楚:模型能力要真正创造价值,最终取决于工程与调用体系能否把能力稳定地交付出去。