智谱创始人、首席科学家唐杰以及 GLM 团队发布长文披露,GLM 已不再只是辅助工程师写代码,而是开始直接参与自身推理基础设施的建设与优化。在 GLM-5.3-Flash 上线过程中,由 GLM-5.3 驱动的 Infra Agent 完成了这项过去需要一支资深 infra 团队数周才能完成的工作。
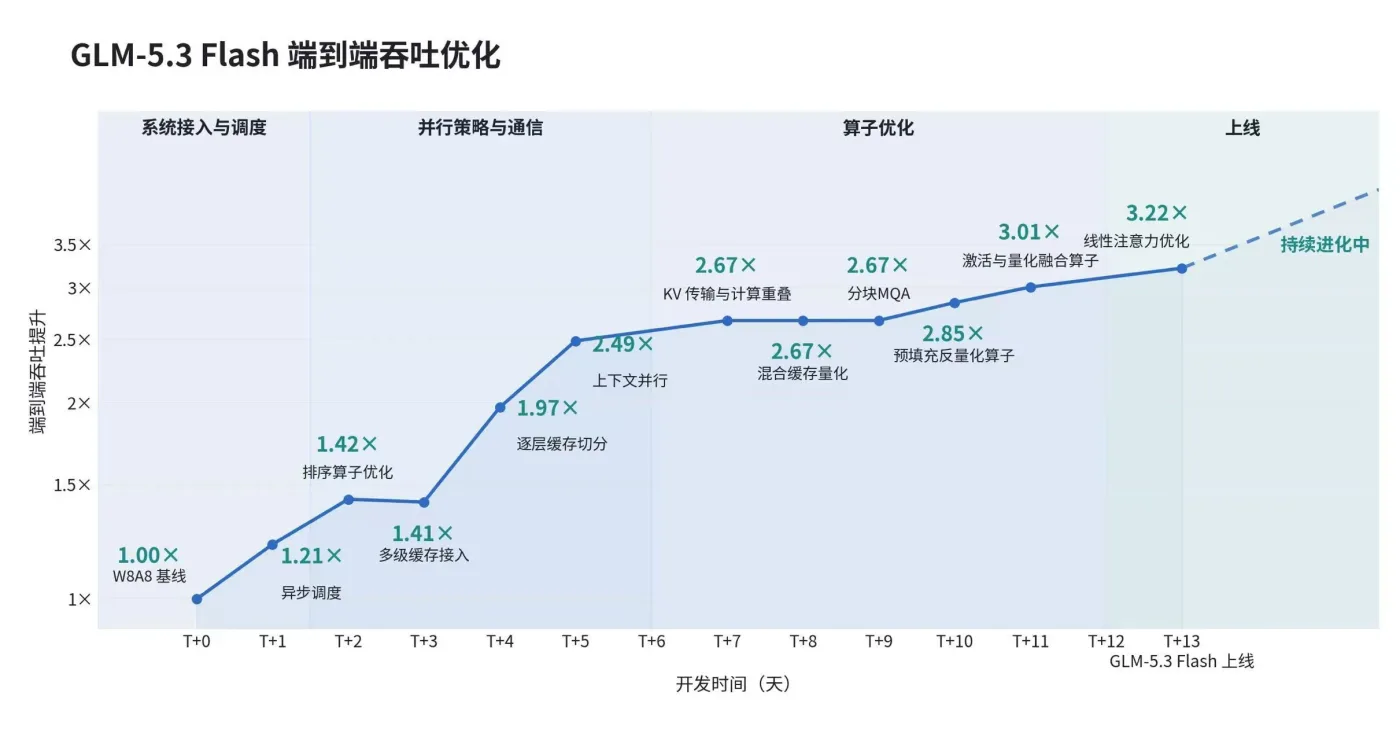
具体来看,在超过 10 万张国产芯片组成的集群上,团队从零搭建了一套完整的生产级推理服务,并面对芯片内存容量和带宽相对受限、需要支持新结构模型 1M 上下文窗口和多模态请求、生态不成熟、算子不完备等挑战。最终的适配、诊断和性能优化由 Infra Agent 参与完成,不到两周把端到端吞吐提升至初始基线的 3 倍。
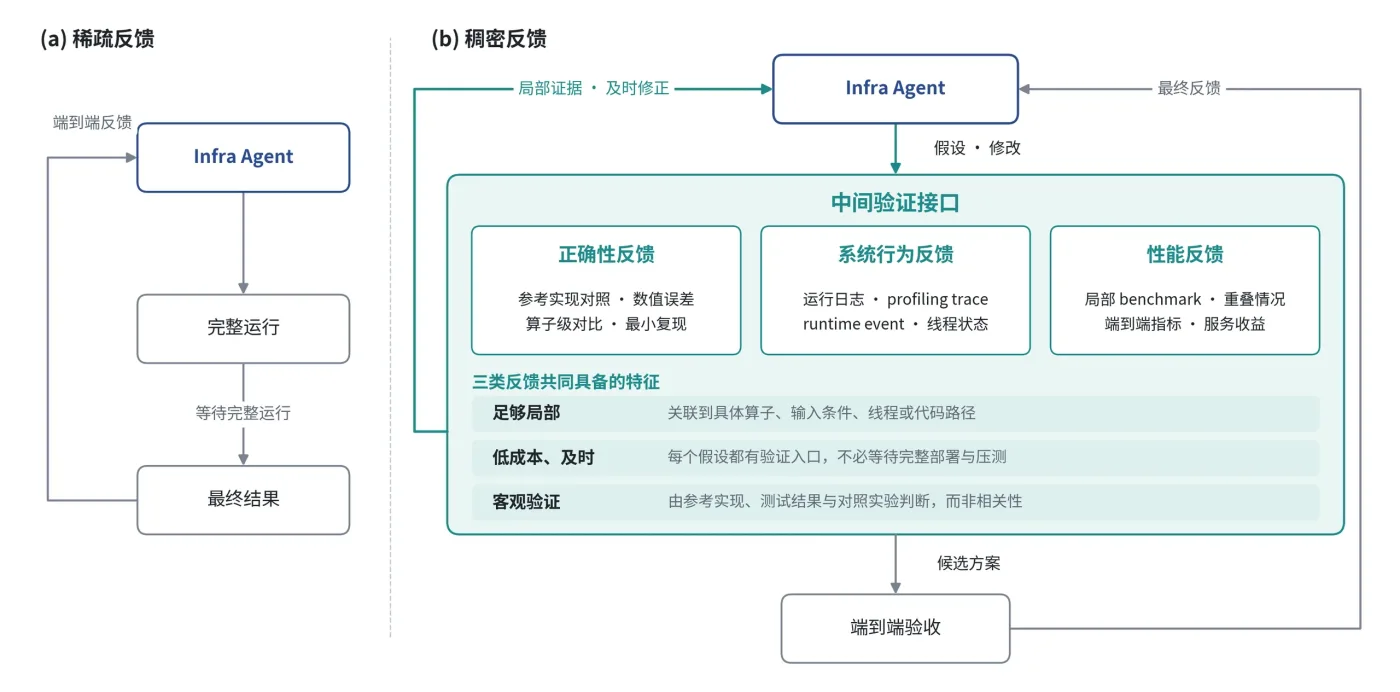
团队认为,这还不是完整意义上的递归自我改进,但已经出现了早期形态:AI 正从“帮助人类研发模型”,走向“参与构建自己的继任者”。Agent 能够根据测试、Trace、Benchmark 等“稠密反馈”自主提出假设、修改代码并验证结果,使模型开始优化承载自身运行的系统。
决定 Infra Agent 工程效果的,不只是模型自身的代码生成与推理能力,更取决于系统能否持续为它提供有效、可归因的反馈。代码库只能提供静态上下文,而精度异常、性能退化往往来自算子实现、并行策略、通信行为、内存管理与服务调度等多个层面的动态交互。端到端指标可以告诉 Agent“结果变差了”,却无法解释“为什么变差”。
这类“模型优化系统、系统承载模型”的闭环,对算力基础设施提出了更高要求。星战 GPU 算力平台通过算力纳管与动态调度,帮助企业在多卡、异构环境中稳定承载训练与推理负载,把有限的工程投入用在真正影响吞吐的环节上。
长文还披露了几个具体案例,包括算子上下文并行路径的精度问题、跨越 Python 与 C++ 边界的 KV Transfer 并发瓶颈,以及关键算子的性能优化。它们共同说明,系统工程的门槛在于把模糊的异常现象,逐步转化为可以验证的工程假设。
智谱也坦言,尚未走到完整的递归自我改进,选择目标、设定边界、判断风险仍然是人的工作。但两周、三倍、十万卡这些数字说明,这条线不会因为我们希望它慢一点就慢下来。