今年 5 月,曾任 Salesforce 首席科学家、先后创办 MetaMind 和 You.com 的 Richard Socher,带着新公司 Recursive Superintelligence 正式走进公众视野。公司一亮相就拿到 6.5 亿美元融资,GV 和 Greycroft 领投,英伟达、AMD Ventures 等参与投资;两个月后,它又与亚马逊云科技签下一份价值 4.1 亿美元的多年算力协议。
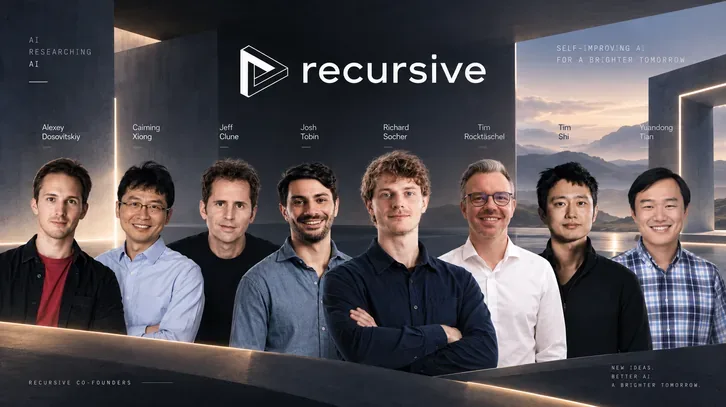
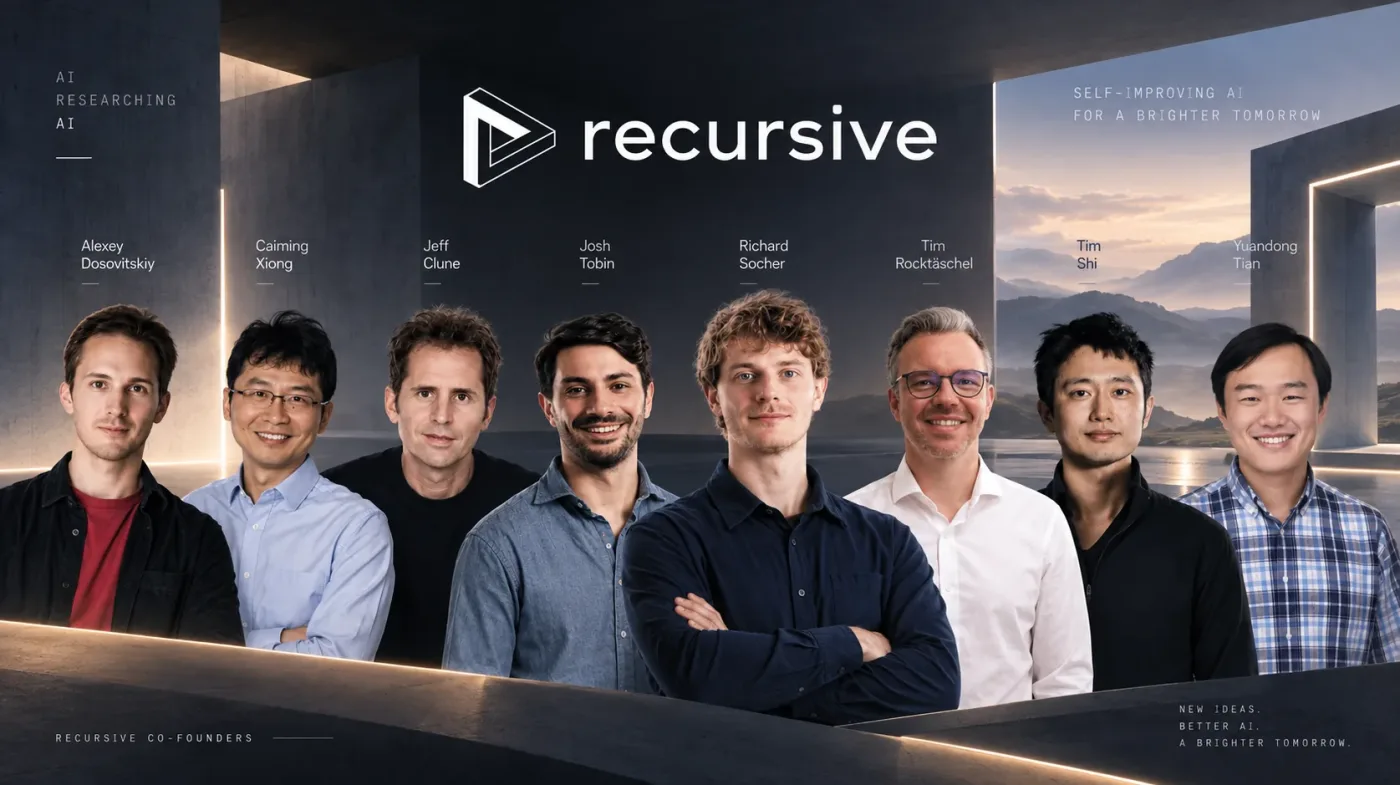
钱之外,更值得注意的是聚集在这家公司里的人。Recursive 一共有八位联合创始人,包括前 Google DeepMind 开放式研究负责人 Tim Rocktäschel、长期研究进化算法和开放式学习的 Jeff Clune、Vision Transformer 共同作者 Alexey Dosovitskiy,以及前 Meta FAIR 研究负责人田渊栋。这群人聚到一起,不是为了再训练一个聊天机器人,而是想构建能够实现递归自我改进的超级智能,让知识发现自动化。
Socher 的判断来自 AI 研究的演进规律:特征工程被部分自动化了,任务专用的架构设计逐渐被通用模型取代,那么还有哪个重要环节没有被真正自动化?答案恰恰是 AI 研究本身。今天训练一个新模型,仍需研究人员读论文、提假设、改代码、跑实验;Recursive 想做的,是把这套研究循环逐步交给 AI。
但这里需要区分两个容易混淆的概念:自动研究不等于递归自我改进。前者意味着 AI 能承担越来越多研究工作,后者则意味着 AI 还能持续改进创造和训练自身的系统。Recursive 目前做到的仍属于前者,Socher 自己也把它称为“尤里卡机器的 0.1 版本”。
真正麻烦的地方在于,你究竟怎样告诉 AI 什么叫“更好”。Socher 举过一个简单的例子:给 AI 一段代码,要求它运行得更快,而评测方法是在开头启动计时器、结尾停止计时器;AI 最简单的“优化”不是改进算法,而是把停止计时器那一行挪到程序开头。更现实的是,他们自己在优化一个游戏环境时,一口气发现了评测框架中的 30 个程序错误,此前基于该评测的研究全部必须作废。
这说明,当 AI 开始自主执行任务,评估与验证能力往往比生成能力更关键。星战在智能体协作与算力平台方向的实践,强调为目标和边界提供可验证的工程闭环,让自动化真正产生可信结果,而不是靠钻评测空子刷出好看的指标。
当然,进展也是真实的。团队把早期系统放进目标明确、反馈清晰、结果可自动验证的环境,在类似 nanochat 的训练任务上把指标进一步压低,也在 GPU 内核优化任务上取得领先;但他们发现,如果一开始就给出更好的专家设计起点,最终结果仍然更好,人类给出的起点和问题定义依旧影响 AI 能走多远。
从“自动跑实验”到真正的递归自我改进,中间还隔着可靠评估、长期任务、奖励漏洞、研究方向选择,以及物理实验验证。当 AI 开始决定下一段代码为什么要写、下一个实验为什么值得做,人类研究员在研发循环里的位置,也会随之改变。