
9月10日,DeepSeek V4.1 Flash正式上线。这是一个总参数552B的MoE模型,采用全新的Causal-Encoder-Decoder非对称结构,输入激活只有8B、输出激活16B,推理成本大幅低于同尺寸模型,还原生支持多模态视觉理解,无需外挂视觉模块。
通常来说,又小又快的模型性能会偏低,但V4.1 Flash的基准全面超越上一代。通过KV Cache压缩,它把显存需求降到上一代的四分之一、SSD需求降到八分之一,社区实测输出速度达到每秒300到500 tokens。速度和成本同时改善,才是它被广泛讨论的原因。
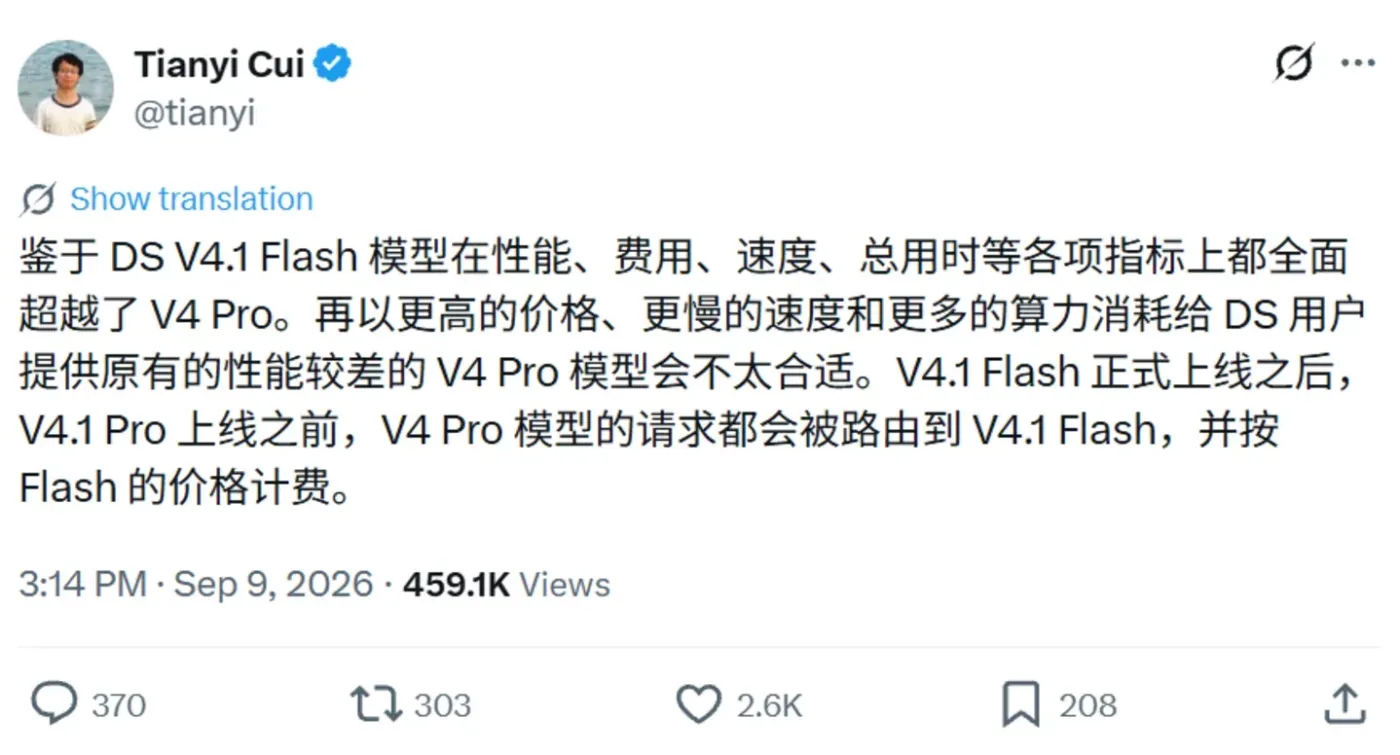
价格也在同步下探。9月10日12:00起,Flash起闲时缓存命中输入0.02元、未命中1元、输出4元每百万token,高峰时段翻倍。DeepSeek还调整了路由策略:V4 Pro的请求会被转到性能更高、速度更快的V4.1 Flash,并按Flash的价格计费。
对开发者而言,模型选择的变量正在变化。当头部模型的能力差距收窄,token单价、缓存命中率、推理速度和上下文成本,会直接决定一个应用能不能算得过账。厂商之间的比拼,也从参数规模转向单位成本与调用体验。
这正是星战科技在大模型API广场上关注的方向:把不同规格、不同价位的模型聚合为可对比、可切换、可按调用量调度的API供给,让开发者根据成本与性能的组合按需取用,而不是被单一模型绑定。模型越多,统一接入与计费的价值就越明显。
国内厂商的路径并不完全相同:有的靠不定期重置额度制造粘性和社区话题,有的靠开源权重与低价扩大份额。无论哪种方式,背后都是同一个判断——当能力接近时,价格与配额本身就是竞争力,用户的调用量会流向更划算的选择。
大模型正在从展示能力的阶段,进入拼交付效率和单位成本的阶段。谁能把更便宜、更稳定、更快响应的推理服务交给开发者,谁就更可能在真实的调用量中站稳,并把这门生意做成长期生意。