
来自Meta FAIR与华盛顿大学的论文《突破Token天花板:蒸馏出更小、更强的字节模型》,提出了一个有意思的想法:蒸馏时能不能把学习单位从词元(Token)换成字节(byte),让学生模型直接从字节级别的概率分布学起?在以Llama 3-8B为教师的实验中,团队按缩放定律预测,随着训练计算量增加,字节级蒸馏将反超Token级蒸馏,下游平均准确率上限高出约4个百分点。
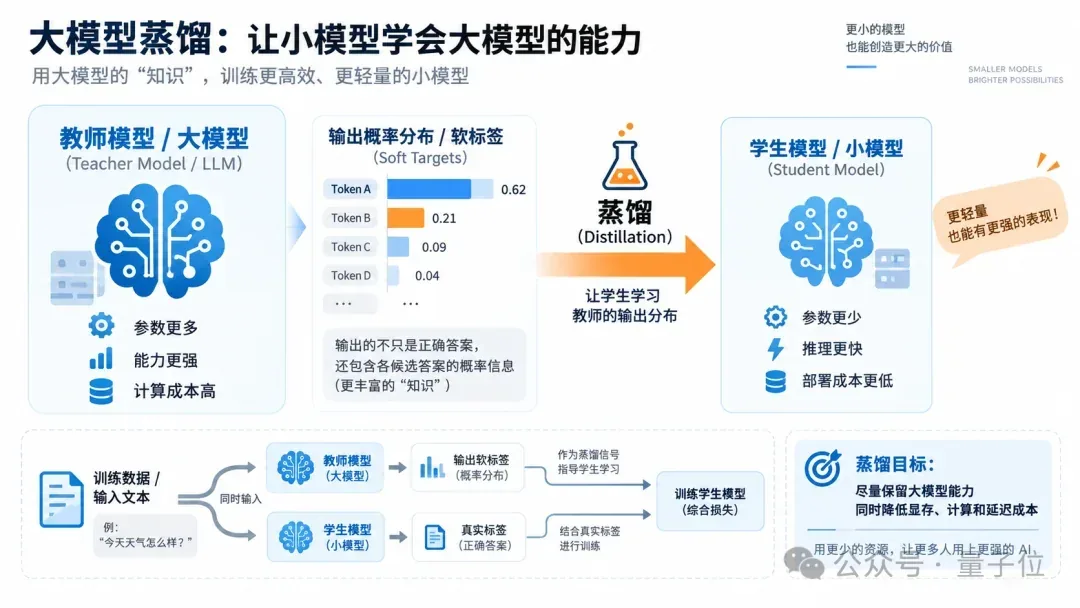
蒸馏并不陌生:让大模型当老师,把能力交给更小的学生模型,以降低显存、计算与响应成本。与监督训练只告诉模型「下一个正确Token」不同,蒸馏还会让学生学习教师对各个候选Token的概率判断。问题也出在这里——以Llama 3-8B为例,词表包含128256个Token,每个预测位置都对应十几万个候选,完整分布很难保存,实际只能做top-k截断。
字节模型恰好把候选空间压小。一个字节由8个比特组成,共有256种可能取值,即使加上少量特殊符号,每个位置需要保存的概率也不过两百多个,完整分布更容易保留。难点在于教师预测的是整个Token,学生预测的是单个字节,要让两者对上,必须把教师的概率分布一起转换过去。
论文提出两种方案:Marginalize-It直接聚合并重新分配概率,只做一次教师前向计算,但会丢掉一部分已经结束Token的概率信息,本质是近似;End-Of-Token则在每个Token末尾加入一个特殊符号,给「Token结束」一个明确的预测位置,从而更完整地把教师分布映射到字节空间。
这与星战科技在大模型API广场与算力调度上关注的方向相通:模型变小、推理变省,并不自动等于好用,关键在于把不同规格的模型统一接入、按任务与成本调度。企业既需要能力强的模型处理难题,也需要小而省的模型承载高频请求,只有可编排、可计量的资源池,才能让成本与效果同时可控。
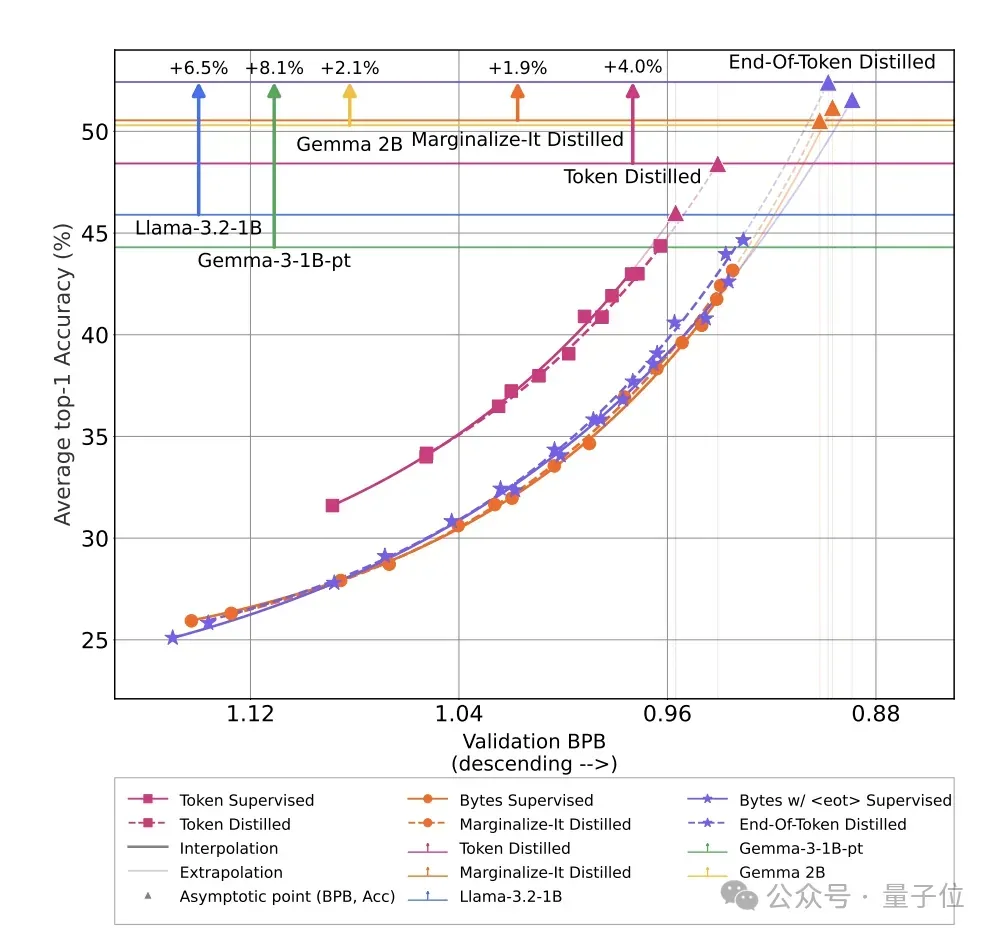
结果也提醒人们不要只看单一指标。字节模型在每字节预测损失上很早超过Token模型,但真正做题时成绩仍可能更低——BPB衡量的是预测得准不准,下游任务看的是答案能否选对。此外,End-Of-Token虽然上限最高,处理相同文本量的训练计算量比普通字节模型还要高约30.94%,推理成本也尚未完成等成本比较。
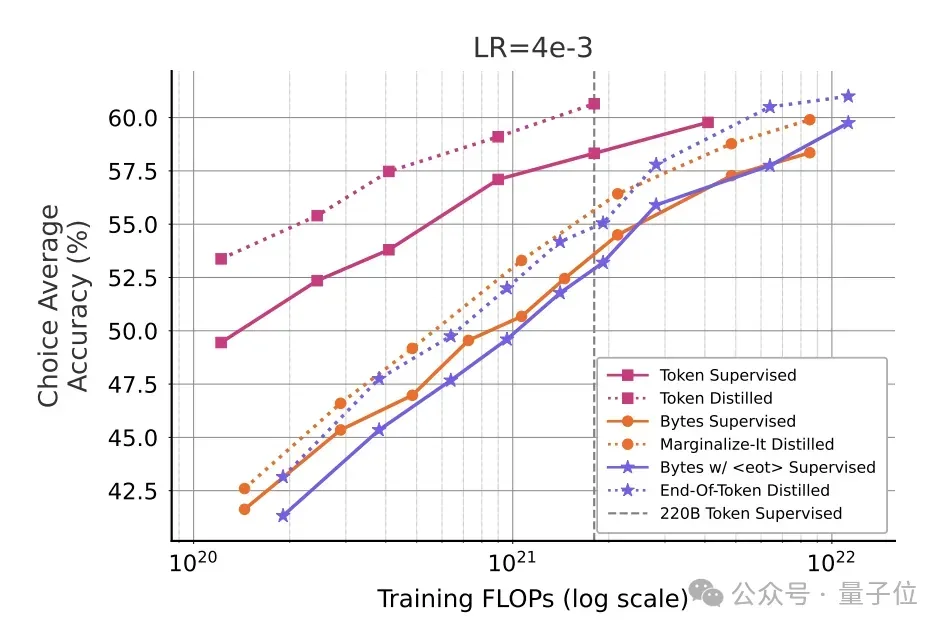
这项工作展示了一条小模型训练的新路径:用更小的预测空间和更少的训练文本,争取更高的能力上限。但潜力要兑现,仍需要持续投入计算与更公平的评测。