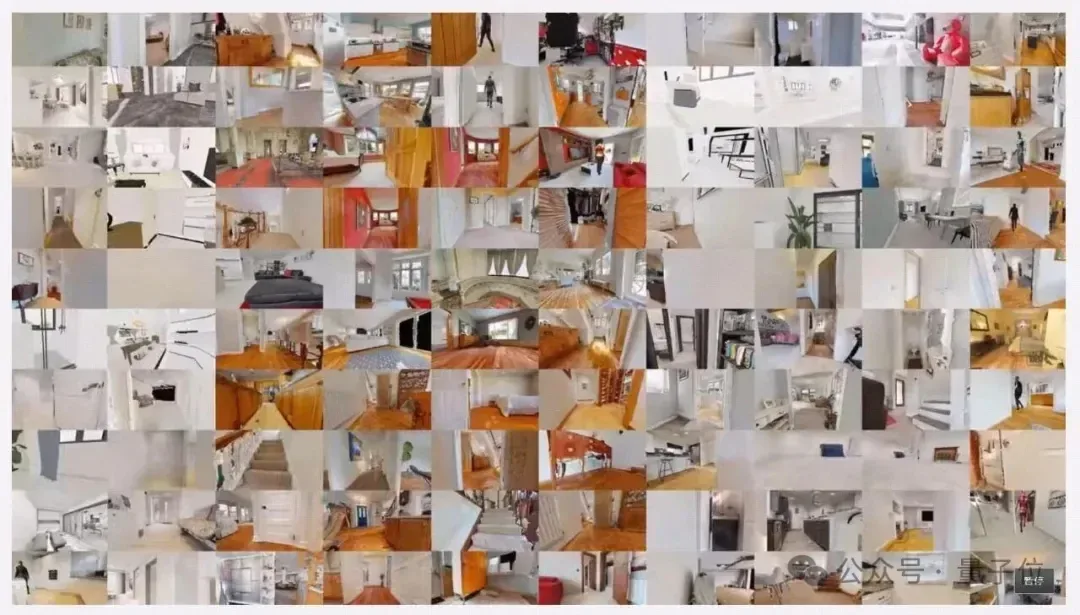
过去一年,具身智能的技术迭代明显加快,VLA、世界模型持续演进,强化学习重新成为机器人学习的重要路径。但一个更基础的问题正在浮现:机器人“会做”一件事,和它能在开放环境中长期、稳定、泛化地把事情做成,其实是两回事。
过去的机器人研发大量建立在任务分解之上:导航解决导航,运动控制解决运动控制,机械臂操作解决机械臂操作。任务和环境越明确,工程系统越容易针对性优化。但通用机器人面对的是环境会变、任务会变、本体会变,甚至自身身体状态也会变。
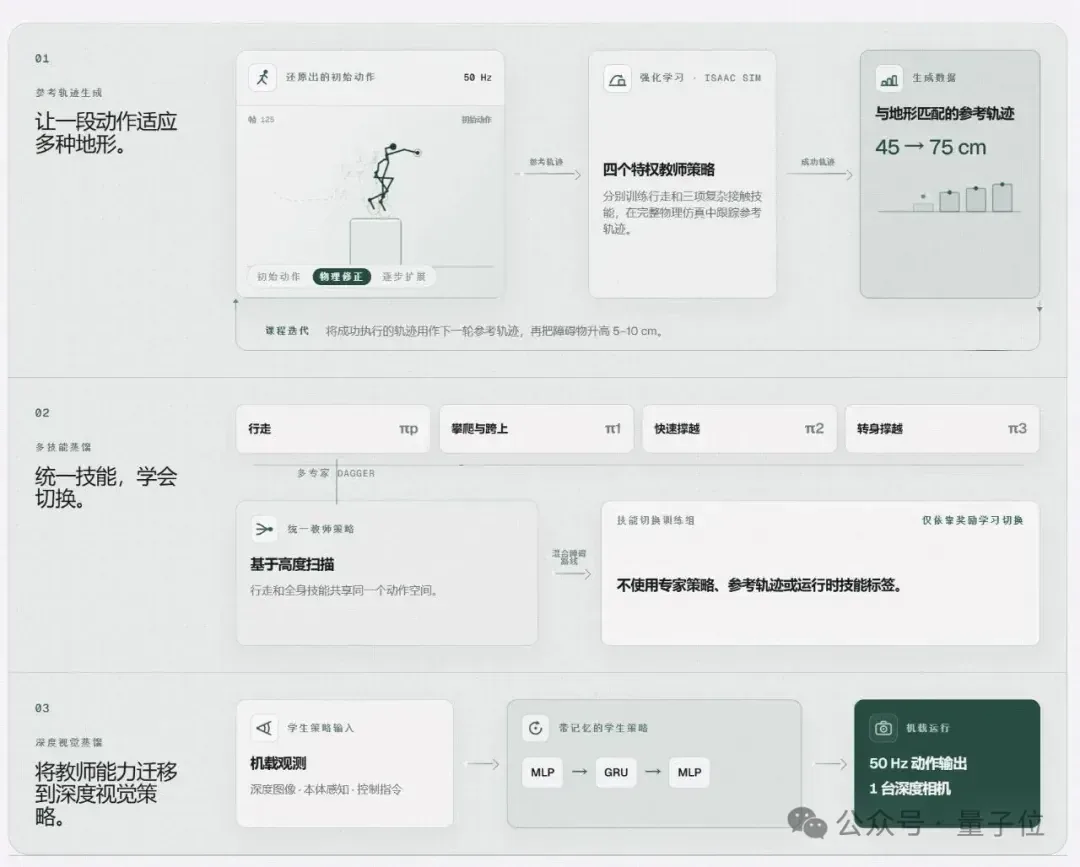
亮源新创接连发布的三项技术,从不同方向回应这个问题。LightParkour从真实的简短人类动作片段出发,把动作与障碍物一起放进物理仿真,用课程学习让技能自己生长,从针对45厘米障碍的动作逐步扩展到75厘米;LightNav-0基于Real2Sim2Real数据引擎,把2000多个互联网来源的真实场景转化为可反复使用的仿真环境,生成4000多小时视觉、语言和动作经验。
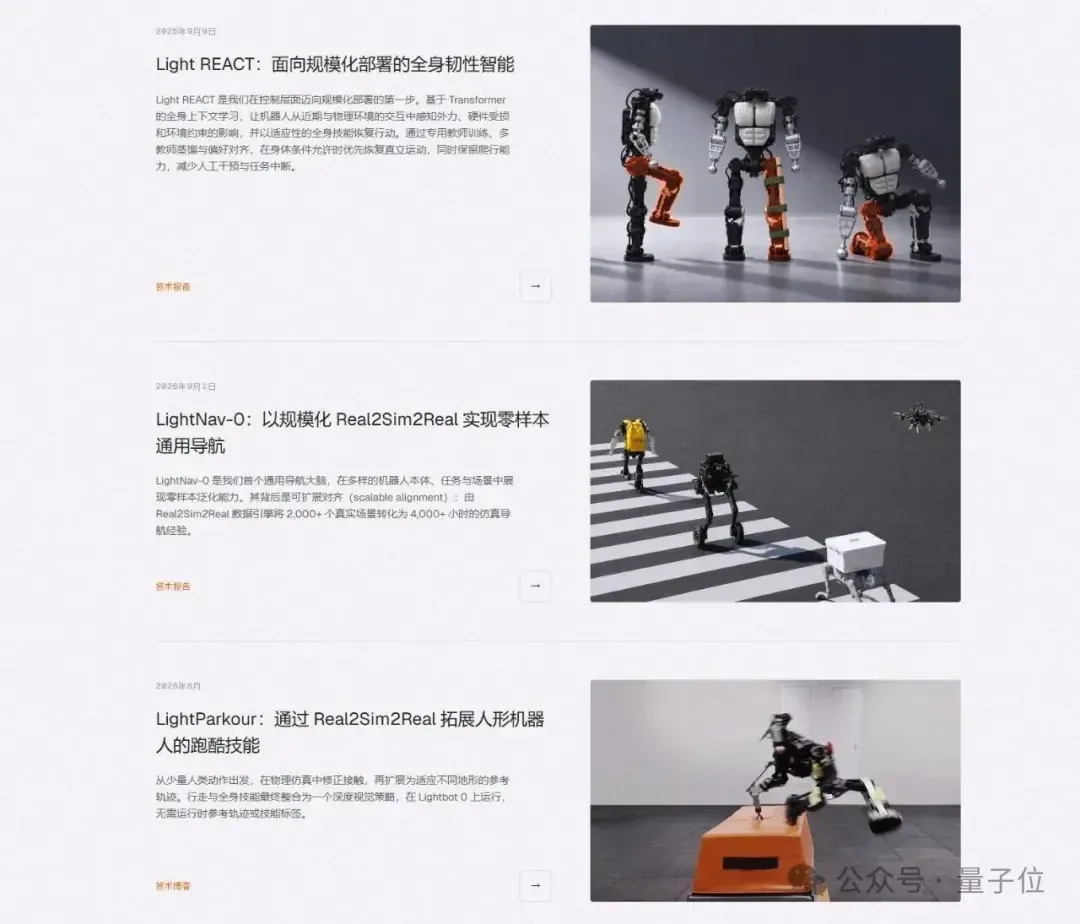
如果每增加一个任务就重训一个模型,每换一个本体就重新适配一次,每出现一种异常状态就重新设计一套规则,能力看似在增加,开发和部署成本也在同步增长。具身智能需要的不是不断增加孤立技能,而是建立一套可以持续扩展能力边界的学习机制。
这套从训练、对齐到真实部署的闭环,与星战科技在GPU算力平台与算力调度上的思路相通:规模化预训练、仿真生成和真机任务共享可编排的算力资源,按负载被执行,而不是各自为战。当数据与模型规模持续变大,能否把分散算力组织成统一资源池,直接决定迭代速度。
部署阶段的韧性同样关键。Light REACT面向外力扰动、跌倒和硬件损伤条件下的全身控制,部署时不会获得故障标签,只能依据自身的交互历史判断身体状态。经过偏好强化学习,公开实验中直立行为比例从约42%提高到约76%,爬行行为从约45%下降至约16%。
具身智能的竞争,最终比的不是单个动作有多炫,而是能否把一个样本扩展成一类技能、把多个专家压缩成一个统一模型、把真实部署的经验重新送回训练体系。谁先跑通这个由真实世界数据驱动的闭环,谁就更接近规模化落地。