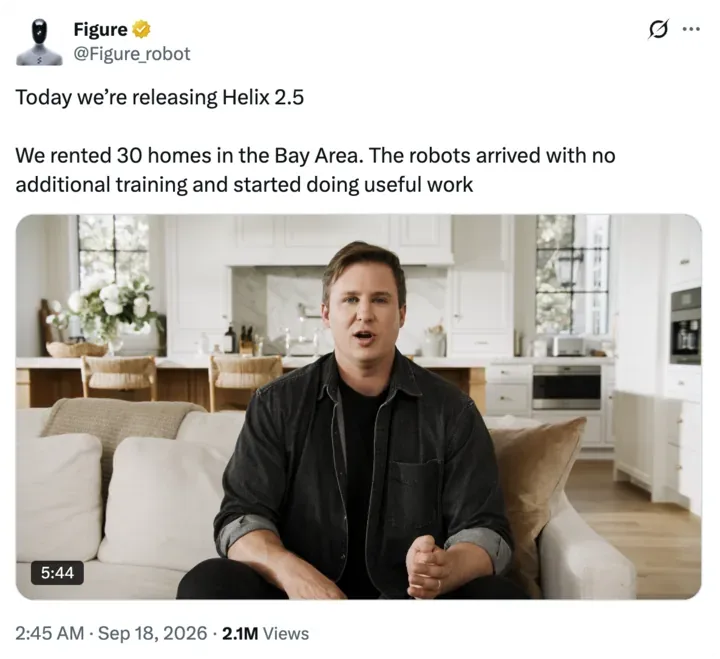
9 月 17 日,Figure AI 发布了新一代模型 Helix 2.5,在 30 个真实的湾区民宅里做了一次零样本测试。在 420 次试验中有 237 次成功,零样本成功率为 56%,评测过程为盲测,且没有任何单一评测任务在预训练数据中的占比超过 1.90%。
作为参照,同样硬件、同样任务数据、只是没有经过 Index 预训练的策略,成功率只有 9%。随着预训练数据的增加,机器人的表现呈现出可预测的、类似语言模型的比例关系:在其他条件不变的情况下,预训练让零样本任务的成功率从 9% 提升到 56%,整体成功率提升了 522%。
这一点之所以重要,是因为过去几年里几乎所有“看起来很厉害”的家用机器人演示,都依赖大量场地专属数据或人工远程操作。Figure 上一代模型能完成连续几十步的长时任务,但也需要先在目标场地采集数据。Helix 2.5 想回答的,是机器人能不能走进一个从没见过的家,直接开始干活。
支撑这一变化的是数据采集体系 Index。官方披露,Index 累计上传视频超过 1600 万条,上传速度一度达到每秒 30 分钟人类工作量;Figure 已为此支付 1500 万美元,并计划在未来 12 个月投入超过 10 亿美元用于数据和算力,把采集规模再扩大 100 倍。公司负责人明确表示,要把人形机器人送进家庭,眼下最大的瓶颈就是数据和算力。
当具身智能把规模押在数据与算力上,底层算力供给的效率就决定了迭代速度。星战 GPU 算力平台与异构集群方案,帮助团队把分散的算力统一池化、按需调度,让大规模训练与推理的投入更可控,也更容易随数据规模增长而平稳扩展。
当然,56% 的成功率并不意味着机器人永远会失败,因为模型在长任务中已经具备自我修正和重试的能力。但评测目前只有三类任务,扩大样本、覆盖更多真实场景,仍是把“能演示”变成“可部署”的必经之路。
从演示到可部署,具身智能还有真实生活的混乱要跨越:地毯上的积木、沙发缝里的充电线、孩子临时堆起的玩具,都会改变原本可行的路线。模型越依赖数据与算力,谁把这两件事做得更高效,谁就更接近真正的规模化。